在2026云栖大会技术主论坛上阿里云提出面向Model、Harness、Context三个维度加持Agent的落地,其中面向Context,让Agent持续理解企业知识、业务状态和执行反馈是决定Agent能力上限但最难标准化的一环。对此,阿里云CTO李飞飞进一步强调围绕”存储—计算处理—上下文工程”阿里云的Context Engine将企业全域数据转化为实时上下文,让Agent从”知道什么”走向”此刻应该做什么”。
围绕这一理念,阿里云同步推出Agent Context、ApsaraLakebase、OpenLake迈向Agentic Lake、AI原生数据库服务(AIDBS)及AI原生大数据服务ADA等产品的发布和重大升级。
上下文不再是会话级临时数据,而是企业新型数据资产
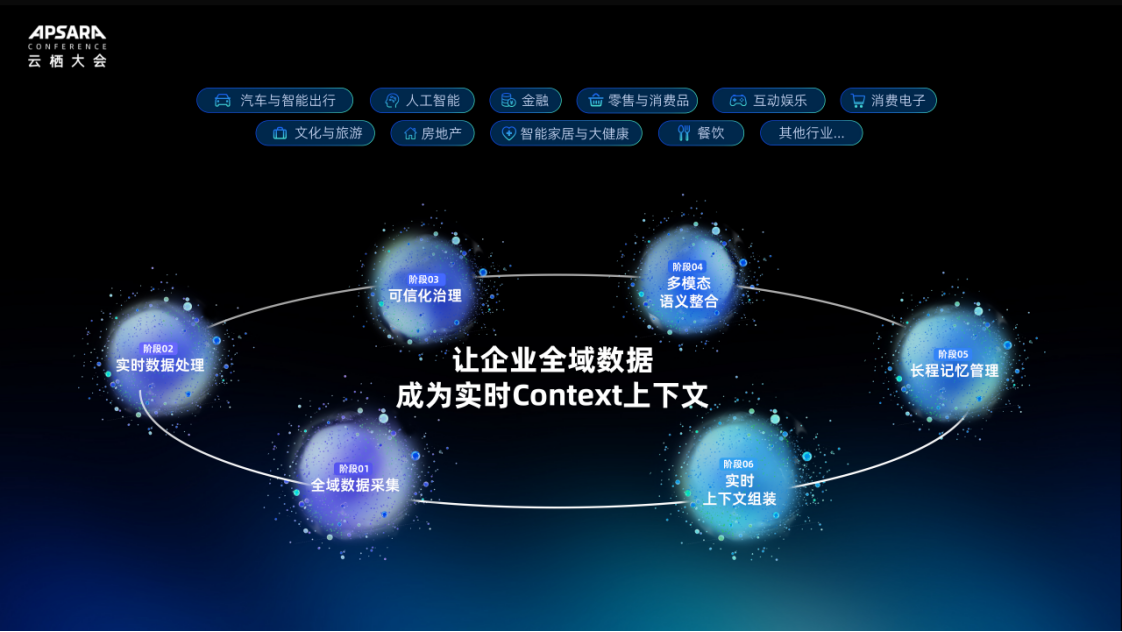

决定Agent能力上限的不只是模型参数,还包括能否持续理解企业知识、业务状态和执行反馈。因此,上下文不再是应用侧的一段临时对话数据,而正在成为企业需要统一建设和治理的新型数据资产。
OpenLake迈向Agentic Lake:一份数据打通Data+AI全链路
阿里云副总裁、阿里云计算平台事业部负责人汪军华指出数据在三个环节中流动驱动智能进化从数据到智能——数据作为模型训练的燃料形成支撑能力;从智能到应用——智能支撑业务上下游完成工作;从应用到智能化——应用产生的轨迹和反馈经筛选评估后用于下一轮AI学习“三个环节连接模型、Agent和支撑系统形成持续改进的闭环。”
阿里云OpenLake进一步迈向Agentic Lake——以统一、实时的开放湖存储承载全模态数据推动大数据、搜索与AI引擎达到跨引擎协同并达到智能体就绪通过DataWorks构建的跨引擎语义层将数据赋能智能体服务,并以AI原生大数据服务ADA支撑多智能体协同企业,基于OpenLake开放湖仓构建的全模态数据能够服务于BI、AI与Agent赋能企业步入全模态开放数据湖智能体时代。
在AI原生化方面阿里云全新发布AI原生大数据服务ADA——一款智能体形态的产品采用多智能体协同架构用户在统一的对话入口通过自然语言即可调用离线、实时、流式分析、AI训推、搜索等不同计算引擎并驱动多个Agent协同完成数据分析、工程、治理、运维和数据科学等端到端任务。
应对大规模分布式训练的效率挑战人工智能平台PAI-DLC 3.0正式发布原生支持真武M890 64卡超节点结合HPN 8.0与CIPU 2.0构建多级拓扑万卡互联的算力底座推出全新智能诊断Xfuse模块融合算力底座、训练框架、任务运行三层洞察由Agent自动完成根因定位保障训练任务运行无忧。在模型训练实战中多模态模型端到端训练提速2.4倍Qwen 3.8强化学习吞吐提升3.8倍。
数据底座全面升级:从企业“多模数据”,走向Agent“Context”
阿里云智能集团研发副总裁、数据库产品事业部负责人杨辛军透露,过去1年阿里云 RDS PostgreSQL 的新增实例数量,已环比增长超过 400%+。其中,约 80% 新增实例由 Agent 所创建,输入输出流量中约 50% 由 Agent 交互和驱动。
“企业的数据越来越成为 Agent 的 Context, 不同的数据 Context 决定了 Agent 能力、深度和广度。”为此,阿里云数据库在会上推出 ApsaraLakebase 与 Agent Context 2大重磅新品,重构从多模态数据存储、实时上下文工程到Data Agent平台的全链路数据底座。 [参考]
其中,ApsaraLakebase以“一份数据、多种引擎、统一治理”的架构,同时接住 Agent 的训练和推理数据。它基于云原生共享底座构建,以对象存储为单一事实数据源,数据只存一份。ApsaraLakebase 支持 Lance、Apache Iceberg、Apache Paimon 等开放数据格式,叠加缓存、引擎、语义与接口能力,让结构化数据、非结构化文件、向量索引、图关系和上下文记忆在同一套体系内流转,真正实现“数据不搬家,一次入湖,处处可用”。
头部基模厂商昆仑万维的Agent平台深度应用了ApsaraLakebase,构建可快照、可共享的弹性存储底座,支撑了海内外300万+ Agent 的独立工作空间、10W级并发连接峰值,深度睡眠后沙箱拉起挂载 P99 达秒级。
另一款全新发布的Agent Context,是面向企业级 Agent 提供实时上下文与记忆底座的数据服务,也是让数据库从“可调用”,走向“可托付”的关键一步。
Agent Context 把各类文档、业务系统、个人经验、图片和音视频等信息源统一接入,基于业务语义管理记忆、知识与 Skill,让上下文可以跨会话、跨任务、跨 Agent 复用,让知识在工作中持续生长,让企业Agent越用越懂业务,Token 使用效率可提升3倍以上。围绕研发协同、运维支持、技术服务、数据分析等知识密集型场景,Agent Context 对复杂知识任务的准确率可提升高达 50 个百分点,并能在单个工作空间内调度上万个智能体。
以小红书为例,小红书以 Agent Context 为数据管理智能体搭建统一上下文底座,支撑 DBA、开发、算法等 3000+ 员工的子 Agent 协同作业,让整个 Agent 集群在同一业务知识域下共享同一套 Context。业务规则一次更新,所有具备权限的 Agent 在后续调用中即可获取最新上下文,无需再逐个喂料,从源头消除经验孤岛与规则失准。
在应用层,阿里云数据库也对企业级Data Agent Platform——AI原生数据库服务(AIDBS)进行了全面升级。围绕数据发现、数据管道、分析与机器学习、预测、治理和安全运维等环节,AIDBS 为用户提供了面向企业数据全生命周期的Agent能力,实现数据应用从“由人构建”到“Agent 自主构建”的跃迁。
阿里云数据库已升级为“可被托付”的 Agentic 数据平台。数据库不再只是保存数据、响应查询,而是要成为 Agent 理解世界、积累经验和创造业务价值的数据底座,让 AI 真正进入生产流程、走向价值创造。
围绕Context Engine,阿里云正打造覆盖数据旅程所有阶段的高质量Agent-Native数据服务——从多模态数据的入湖存储、语义抽象与上下文装配,到实时计算、记忆管理与自然语言访问,让企业全域数据真正成为Agent可理解、可调用、可持续进化的实时上下文。
免责声明
本站转载的文章,版权归原作者所有;旨在传递信息,不代表本站的观点和立场。不对内容真实性负责,仅供用户参考之用,不构成任何投资、使用等行为的建议。如果发现有问题,请联系我们处理。
本站提供的草稿箱预览链接仅用于内容创作者内部测试及协作沟通,不构成正式发布内容。预览链接包含的图文、数据等内容均为未定稿版本,可能存在错误、遗漏或临时性修改,用户不得将其作为决策依据或对外传播。
因预览链接内容不准确、失效或第三方不当使用导致的直接或间接损失(包括但不限于数据错误、商业风险、法律纠纷等),本网站不承担赔偿责任。用户通过预览链接访问第三方资源(如嵌入的图片、外链等),需自行承担相关风险,本网站不对其安全性、合法性负责。
禁止将预览链接用于商业推广、侵权传播或违反公序良俗的行为,违者需自行承担法律责任。如发现预览链接内容涉及侵权或违规,用户应立即停止使用并通过网站指定渠道提交删除请求。
本声明受中华人民共和国法律管辖,争议解决以本网站所在地法院为管辖法院。本网站保留修改免责声明的权利,修改后的声明将同步更新至预览链接页面,用户继续使用即视为接受新条款。
